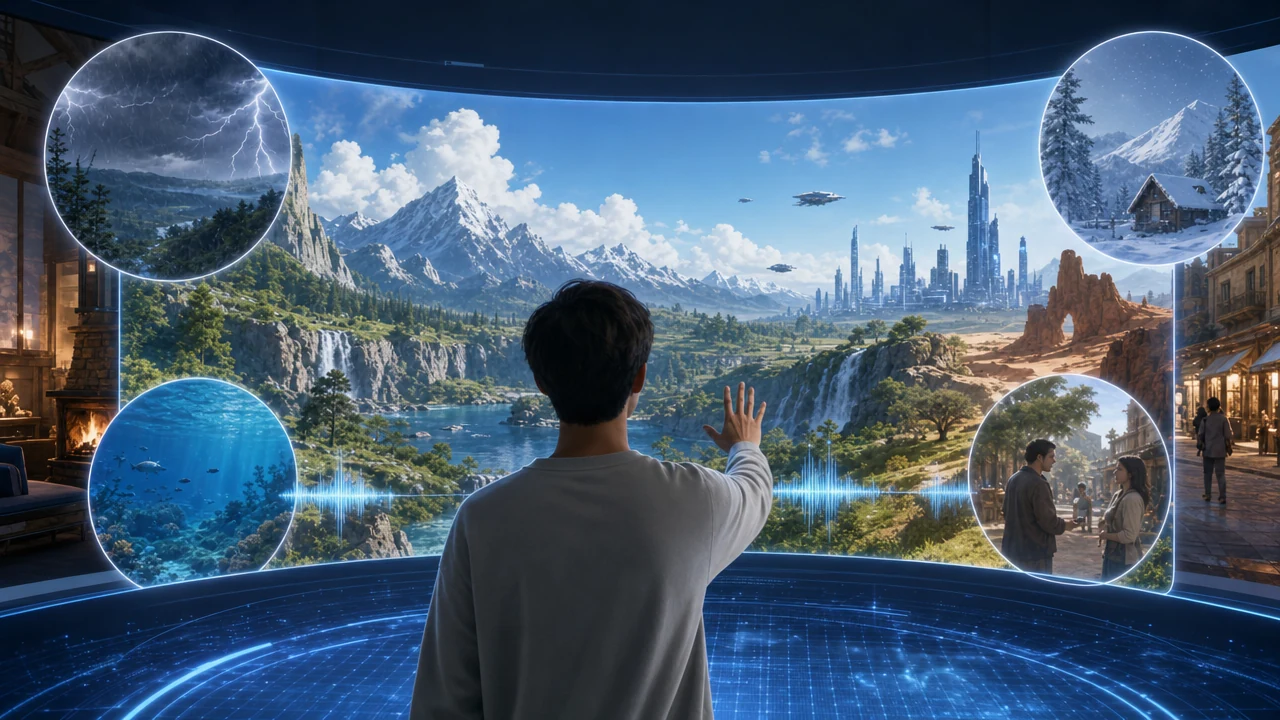
2026 年 10 月 27 日,Google DeepMind 正式公布了新一代世界模型(World Model)Genie 4 的研究进展。
作为面向实时交互式模拟的前沿模型,Genie 4 的升级方向非常明确:官方宣称其带来了“前所未有的真实感”,首次支持**原生音频(native audio)**生成,同时将单次模拟时长提升至最长约两分钟——这一时长达到了前代模型 Genie 3 上限的两倍,也被外媒 Quartz 评价为“迄今最逼真的 AI 世界模型”。
不过在深入探讨这项技术之前,有一点需要先行校准:尽管外界普遍将这一消息称为“Genie 4 发布”,但谷歌官方公告的措辞是“公布 Genie 4 的研究进展(announcing our research on Genie 4)”。目前该模型尚未面向普通公众全面免费开放,而是处于小范围受信任测试阶段,后续将逐步通过订阅服务与开发者 API 渠道释出。
那么,被谷歌频频提及的“世界模型”究竟是什么?从 Genie 1 到 Genie 4 的快速迭代解决了哪些痛点?它离真正的工业级应用还有多远?
一、 Genie 4 是什么?为什么谷歌如此执着于“世界模型”?
在生成式 AI 领域,大众对文本大模型和视频生成模型(如 Veo)已经不再陌生。但如果说传统视频生成模型做的是“拍电影”——根据提示词生成一段只能被动观看的线性画面,那么世界模型做的就是“造世界”。
按照 Google DeepMind 给出的定义,世界模型是一种利用其对世界的理解来模拟环境演变的 AI 系统。它不仅能生成画面,还能让智能体(或人类用户)预测环境将如何随时间变化,以及自身的行动会对这个环境产生怎样的影响。Project Genie 团队将这一技术趋势概括为从“被动视频生成”向“交互式媒体”的跨越:面对 AI 生成的画面,你不再只是旁观者,而是可以实时走进去,与其中的物体和环境互动。
谷歌之所以在这一方向上持续重金投入,源于其对通用人工智能(AGI)路径的判断。
Google DeepMind 拥有十余年模拟环境的研究传统,从早期在即时战略游戏中训练智能体,到后来的开放式学习与机器人仿真环境,一脉相承。在官方叙事中,“模拟世界”被视为通向 AGI 的关键阶梯,其核心价值体现在两个维度:
- 智能体与机器人的安全训练场:在虚拟世界中模拟物理规律与复杂场景,让机器人和 AI 智能体在零风险、低成本的环境中进行试错与学习。
- 跨行业的创意生产力工具:为电影制作、新闻报道、视频游戏开发以及制造业等行业提供全新的交互式内容生成工具。
二、 两年四代跃迁:从 Genie 1 到 Genie 4 的进化史
如果把时间拉回两年前,最初的 Genie 还只能生成模糊、卡顿的二维画面。在不到三年的时间里,Google DeepMind 完成了四代技术跃迁,其演进速度清晰地展示了世界模型的技术攻关方向:
| 代际 | 公布时间 | 核心突破与关键能力 | 关键规格与局限 |
|---|---|---|---|
| Genie 1 | 2024 年 3 月 | 首个完全从无标注互联网视频中进行无监督训练的生成式交互环境;支持文本、合成图像、照片或草图作为提示 | 参数量 11B;仅能生成 2D 环境,渲染速度仅约 1 帧/秒(1fps) |
| Genie 2 | 2024 年 | 跨入三维空间,能够生成细节丰富的交互式 3D 世界;可对跳跃、游泳、移动物体等动作做出逼真响应 | 视觉记忆上限约为 10 秒 |
| Genie 3 | 2025 年 8 月 | 定位为通用世界模型,吸收了 Genie 2 与视频模型 Veo 3 的物理理解能力;实现实时交互与“可提示世界事件” | 达到 720p 分辨率 / 24fps;视觉记忆扩展至分钟级;仅限有限研究预览 |
| Genie 4 | 2026 年 10 月 | 首次引入原生音频生成;画面与物理交互达到“前所未有的真实感”;模拟时长翻倍 | 单次模拟时长最长约 2 分钟;启动有限测试并规划 API 与订阅渠道 |
1. Genie 1(2024 年 3 月):从无标注视频中学会“被控制”
Genie 1 的里程碑意义在于证明了“无需动作标签也能学会交互”。这个 110 亿参数的模型直接通过看海量无标注互联网视频,自己学会了画面变化背后的控制逻辑。但受限于当时的算力与架构,它只能生成类似早期横版过关游戏的 2D 环境,且每秒只有约 1 帧的画面。
2. Genie 2(2024 年):迈入 3D 交互世界
同年晚些时候推出的 Genie 2 实现了从 2D 到 3D 的跨越。它不仅能生成立体场景,还能理解跳跃、游泳、推动物体等动作带来的环境反馈。不过,当时的模型“记性”很短,视觉记忆只能维持约 10 秒——一旦你转头超过 10 秒再看回来,身后的场景可能就已经变样了。
3. Genie 3(2025 年 8 月):实时交互与物理规律融合
2025 年 8 月 5 日发布的 Genie 3 是走向实用化的重要一步。它融合了 Genie 2 的空间能力与谷歌视频生成模型 Veo 3 对物理规律、物体交互的深刻理解,首次将画面拉升至 720p、24fps 的实时交互标准,并将视觉记忆推进到分钟级。同时,它引入了“可提示世界事件(promptable world events)”,允许用户在交互中途随时通过文本改变世界状态。
4. Genie 4(2026 年 10 月):视听合一与时长翻倍
到了最新的 Genie 4,谷歌开始补齐沉浸感的最后一块拼图——声音,并进一步拉长单次模拟的持续时间,让虚拟世界从“几十秒的视觉片段”迈向更完整的多感官交互体验。
三、 拆解 Genie 4:核心能力升级与底层技术逻辑
1. Genie 4 已确认的三大关键突破
结合 Google 官方公告与媒体披露的信息,Genie 4 的核心升级集中在以下三个方面:
- 原生音频生成(Native Audio):前三代 Genie 生成的都是“无声世界”。Genie 4 首次在实时交互模拟中具备了原生音频能力,这意味着当用户在生成的世界中行走、驾驶或触发环境交互时,模型能够同步生成与之匹配的音效与环境声,大幅提升了模拟环境的真实度与临场感。
- 单次模拟时长翻倍(最长约 2 分钟):据 Quartz 报道,Genie 4 的单次模拟时长上限达到了约两分钟,是 Genie 3 上限的两倍。(注:关于前代 Genie 3 的具体时长上限,过往不同资料中曾出现“约一分钟”与“数分钟”等不同表述,但可以确定的是,Genie 4 在单次连续生成与状态维持的时长上实现了显著翻倍。)
- 前所未有的真实感(Unprecedented Realism):在画面光影、物理动态以及复杂场景的细节呈现上,Genie 4 进一步逼近照片级真实(photorealistic),模糊了实时生成画面与实拍视频的界限。
2. 底层机制与交互体验(基于 Genie 系列与 Project Genie 架构延伸)
谷歌在此次研究公告中并未展开底层架构细节,但通过 Genie 1 至 Genie 3 已经公开的技术脉络,以及搭载该模型的实验性原型产品 Project Genie,我们可以清晰地还原这套系统的工作逻辑。
在技术底座上,Genie 系列属于时空 Transformer(Spatiotemporal Transformer),负责同时建模每一帧画面的空间内容以及场景随时间的演变。早期的 Genie 1 确立了三大核心组件:时空视频分词器(tokenizer)、自回归动力学模型,以及可扩展的潜动作模型(latent action model)。正是潜动作模型的存在,使得 AI 无需人类预先标注键盘按键或手柄指令,就能从纯视频中自己推导出“帧与帧之间发生了什么动作”,进而实现逐帧受控生成。
在产品交互层,用户接触 Genie 模型的主要载体是 Project Genie。参考已公开的 Project Genie 工作流,构建并探索一个虚拟世界通常包含以下步骤:
- 多模态建世:系统底层集成了 Gemini 来理解用户的自然语言提示词,并由 Genie 模型负责画面生成。用户可以通过输入文本,或者上传、生成一张图像,来定义世界的外观与角色。
- 世界草图与微调(World Sketching):在正式进入世界前,Project Genie 集成了 Nano Banana Pro,允许用户先预览生成的静态图像并进行修改微调,同时设定采用第一人称还是第三人称视角。
- 自定义移动与实时控制:用户可以定义角色在世界中的移动方式(如步行、骑行、飞行或驾驶)。进入世界后,系统会根据用户的键盘操作(如 WASD 控制移动、方向键转动视角、空格键上升)实时生成前方的路径与画面,并支持调整相机角度。
- 重混与实景融合:系统支持“世界重混(world remixing)”,即在已有世界的基础上二次创作,甚至集成了 Google 街景(Street View)数据,让现实世界的街景转化为可自由探索的生成式环境。
3. 待核实与未披露的技术盲区
需要客观指出的是,由于此次官方仅发布了简短的研究公告,关于 Genie 4 的多项硬核技术指标目前尚未披露。
这包括:Genie 4 的具体输出分辨率与帧率(外界尚不能直接将 Genie 3 时期的 720p/24fps 默认套用在 Genie 4 上)、模型参数规模、具体的网络架构改动、是否依然保留或升级了“可提示世界事件”功能,以及官方是否会同步放出正式的学术论文或技术报告。这些细节仍有待 DeepMind 团队在后续测试周期中进一步揭晓。
四、 典型应用场景:不止于“AI 造游戏”
随着 Genie 4 将模拟时长推向两分钟并补齐原生音频,世界模型的应用潜力正在向多个行业渗透。
1. 游戏原型设计与交互式娱乐
这是普通用户最容易感知的领域。在 Genie 3 时期,由于生成的世界具备真实的物理反馈,物体会对玩家的交互做出反应,已经有外媒记者利用提示词在 Project Genie 中快速搓出了类似《塞尔达传说》或《马里奥》风格的仿制场景与“迷你游戏”。
行业观察人士指出,这类技术未来不仅能帮游戏开发者快速验证关卡与玩法原型,还能让普通用户按照个人偏好实时构建专属的自定义世界,甚至催生出全新的游戏类型。一个耐人寻味的侧面细节是:此前当谷歌发布 Genie 系列进展时,资本市场反应敏感,一度引发多家传统视频游戏公司的股价下跌。
2. 机器人与具身智能(Embodied AI)训练
如果说“造游戏”是面向消费者的展示窗口,那么机器人训练才是 DeepMind 研发世界模型最核心的战略诉求。
在真实物理世界中训练机器人或自动驾驶算法,不仅成本高昂、效率低下,还伴随着极高的硬件损坏与安全风险。Genie 系列能够为具身智能提供“无限的虚拟训练空间”。例如,研究人员可以生成自动驾驶汽车在极端恶劣天气中行驶的场景,或是模拟翼装飞行者在复杂山地间滑翔的物理环境。通过“可提示世界事件”人为制造各种突发意外,训练智能体在极端长尾场景下的应变能力。
3. 影视制作、内容创作与教育
在官方公告中,Google 特别点名了电影制作、新闻、游戏和制造业。对于影视与动画创作者而言,Genie 4 的高真实感与原生音频能力,使其非常适合用于快速生成奇幻场景、制作富有表现力的动画角色,或是在正式拍摄前进行低成本的交互式镜头预演(Pre-visualization)。
此外,在教育与科研场景中,世界模型可以将枯燥的教材转化为沉浸式体验——例如在课堂上实时生成一座古代城市,或是一片外太空环境,让学生以第一视角在其中自由漫步与探索。
五、 冷静看待:当前局限、技术挑战与上手指南
尽管 Genie 4 展现出的演示效果令人惊艳,但站在开发者与行业应用的角度,我们仍需冷静审视当前世界模型面临的技术瓶颈。
1. 现阶段的四大核心局限
- 本质是 2D 逐帧渲染,而非 3D 资产:这是外界最容易产生误解的地方。参考 Genie 3 的技术特性,模型生成的是“类 3D 环境的逐帧 2D 渲染画面”。换言之,它是在每一秒内实时画出几十张具备三维透视关系的平面图,而不是像 Unity 或 Unreal 引擎那样构建出包含网格(Mesh)、材质和骨骼的可导出 3D 建模资产。你无法直接把 Genie 生成的世界导入到传统游戏管线中继续编辑。
- 世界一致性与长期记忆仍是核心难题:尽管 Genie 4 将单次模拟时长翻倍至约两分钟,但如何在更长的时间跨度内保持环境的物理逻辑与空间一致性(例如离开某个房间十分钟后再返回,桌上的物品摆放依然分毫不差),依然是 Project Genie 团队公认的核心技术挑战。
- 产品形态仍处于早期研究原型:外媒 Mashable 在体验前代 Project Genie 时曾给出过一句非常实在的评价——它目前主要是一个研究项目,“能玩,但本身并不做实际的事(doesn't actually do anything)”。它没有完整的游戏目标、数值系统或工业级工程接口,距离直接替代现有的成熟生产力工具尚有相当长的距离。
- 技术细节与报告缺位:除了初代 Genie 1 在 arXiv 上公开了完整的学术论文外,Genie 3 的技术报告此前一直处于“即将发布”状态,此次 Genie 4 同样尚未公布详尽的技术白皮书,外界难以对其算力消耗与推理成本做出精准评估。
2. 开发者与创作者如何获取访问权限?
目前,Google 为 Genie 4 规划了分批次、多渠道的开放路径:
- 受信任测试者(Trusted Testers):从 10 月 27 日公布当天起,Google DeepMind 已经开始向少量受信任的测试者滚动开放测试权限。
- Google AI Ultra 订阅者:官方表示,Genie 4 将“很快”通过 Project Genie 面向 Google AI Ultra 订阅用户开放。(参考 Genie 3 时期的规则,Project Genie 主要面向美国地区 18 岁及以上的 Ultra 订阅者,访问入口为
labs.google/projectgenie。) - 企业与开发者渠道:早期访问合作伙伴(Early access partners)将能够通过 Gemini API 以及 Google AI Studio 调用 Genie 4 的能力。这也是世界模型从实验室原型走向开发者生态的重要一步。
- 普通用户围观:尚未获得测试资格的公众,目前可以前往 Google DeepMind 官方博客观看 Genie 4 的实时生成演示视频。
结语
从 2024 年初每秒只有 1 帧的二维像素画面,到如今兼具照片级真实感、原生音频与两分钟连续交互的动态三维空间,Genie 系列在两年多时间里的演进,清晰地勾勒出 AI 视觉模型下半场的竞争方向。
Genie 4 的出现再次证明,生成式 AI 的终点绝不仅仅是生成一段供人观看的视频,而是构建一个遵守物理规律、支持多感官反馈、可被实时干预的模拟世界。尽管在 3D 资产转化、超长时空间记忆以及算力成本上仍有诸多留白,但随着 Gemini API 与 AI Studio 的接入,这扇通往“可交互生成世界”的大门,已经开始向开发者与创作者悄然推开。对于游戏工业、影视制作乃至具身智能领域的从业者而言,现在正是持续追踪并思考如何将“世界模型”纳入未来工作流的最佳时机。