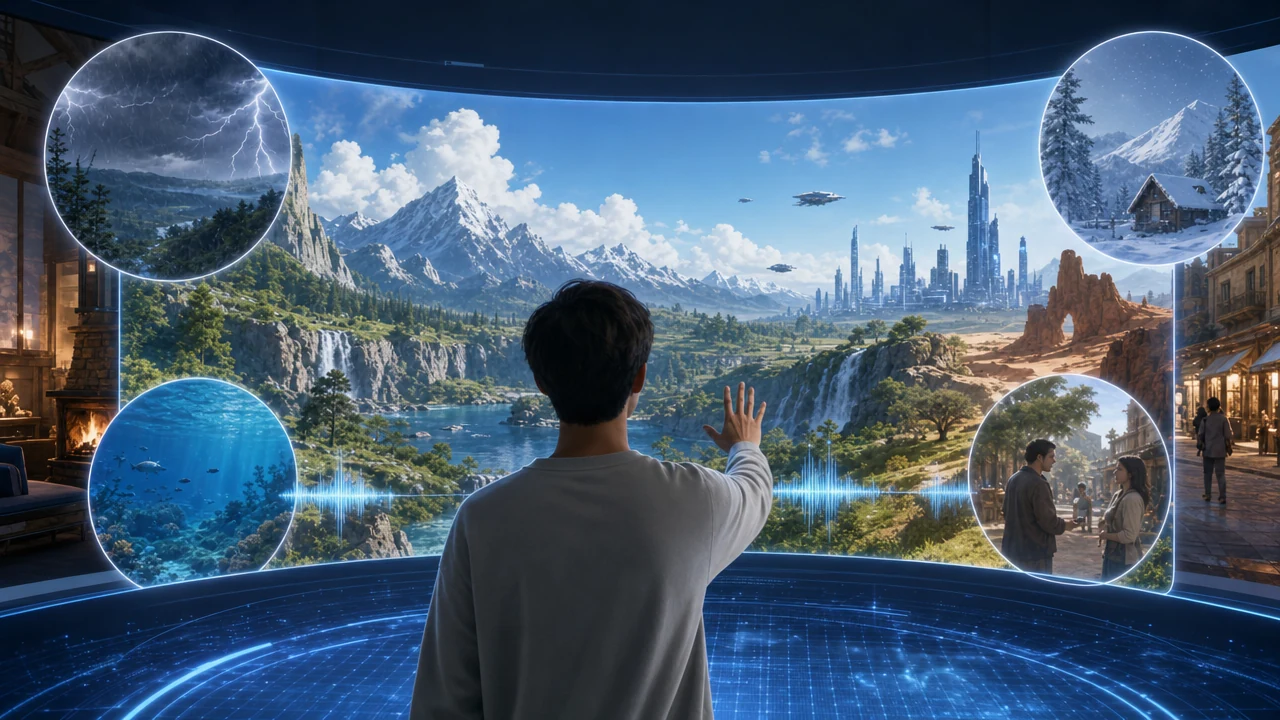
2026年10月27日、Google DeepMindは次世代のワールドモデル(世界モデル)「Genie 4」に関する研究成果を発表しました。リアルタイムのインタラクティブなシミュレーションに特化したこの最新モデルは、公式発表において「かつてないリアリズム(unprecedented realism)」と表現されており、新たにネイティブ音声(native audio)の生成に対応したほか、1回あたりのシミュレーション時間が前世代の2倍にあたる最大約2分間へと大幅に延長されています。メディアのQuartzは、これを「これまでで最もリアルなAIワールドモデル」と評しています。
ただし、最初に留意しておくべき点があります。今回の発表は「Genie 4に関する研究の発表(announcing our research on Genie 4)」という位置づけであり、一般向けに無制限で商用リリースされたわけではありません。現在は少数の信頼できるテスターに向けた段階的な公開が始まった段階であり、今後「Project Genie」やAPIを通じて順次対象が拡大される予定です。
本稿では、公式に確認されている「Genie 4」の最新情報と、前世代から受け継がれてきた技術的背景を明確に切り分けながら、その進化の軌跡、技術的ロジック、産業へのインパクト、そして実用化に向けた課題について詳しく紐解いていきます。
1. Genie 4とは何か?Googleが「ワールドモデル」に執着する理由
AI分野における「ワールドモデル(World Model)」とは、単なる動画生成AIとは一線を画す概念です。Google DeepMindの定義によれば、ワールドモデルとは「世界に対する理解を活用して世界の特定の側面をシミュレートし、エージェント(AIやユーザー)が『環境がどう変化するか』『自分の行動が環境にどのような影響を与えるか』を予測できるようにするAIシステム」を指します。
従来の動画生成モデルが、与えられたプロンプトから「受動的に視聴する映像」を作り出すものであるのに対し、Project Genieチームが掲げるワールドモデルの主軸は**「受動的な動画生成からインタラクティブなメディアへの転換」**にあります。つまり、生成された映像をただ眺めるのではなく、その世界の中にリアルタイムで足を踏み入れ、歩き回り、環境に働きかけることができるのです。
Google DeepMindがこの分野に注力する背景には、10年以上にわたるシミュレーション環境研究の伝統があります。かつてのリアルタイム戦略ゲームにおけるエージェント訓練から、オープンエンドな学習、ロボット工学のシミュレーション環境に至るまで、同社は一貫して仮想環境でのAI訓練を追求してきました。
公式発表において、Googleは「世界をシミュレートすることは、汎用人工知能(AGI)への重要なステップである」と明確に位置づけています。その戦略的な狙いは大きく2つあります。1つは、ロボットやAIエージェントに対して、現実世界のリスクを伴わない「安全な訓練環境」を提供すること。もう1つは、映画制作、ジャーナリズム、ゲーム、製造業といった幅広い産業におけるクリエイティブツールを強化することです。
2. 2年間で4世代の飛躍:Genie 1からGenie 4への進化史
Genieシリーズは、2024年の初代発表からわずか2年余りで第4世代へと到達しました。各世代の進化を振り返ることで、この技術がどのようなスピードと方向性で発展してきたのかが浮き彫りになります。
| 世代 | 発表時期 | 主な特徴と到達点 |
|---|---|---|
| Genie 1 | 2024年3月 | ラベル付けされていないインターネット動画から教師なし学習で訓練された初の生成的インタラクティブ環境。パラメータ数は11B(110億)。テキスト、合成画像、写真、スケッチをプロンプトとして入力可能。ただし生成できるのは2D環境のみで、フレームレートは**約1fps(秒間1フレーム)**にとどまっていた。 |
| Genie 2 | 2024年 | ディテールに富んだインタラクティブな3D世界の生成が可能に。ジャンプ、水泳、物体の移動といったアクションに対してリアルに反応するようになり、約10秒間の視覚的記憶(空間の一貫性維持)を実現。 |
| Genie 3 | 2025年8月5日 | 汎用ワールドモデルへと進化。720p / 24fpsでのリアルタイムなインタラクションを実現し、視覚的記憶は数分間に拡大。「プロンプトによる世界イベントの制御(promptable world events)」に対応。少数の学術研究者やクリエイター向けに限定的なリサーチプレビューとして公開された。 |
| Genie 4 | 2026年10月27日 | ネイティブ音声の生成に初めて対応。シミュレーション時間はGenie 3の上限の2倍となる最大約2分間に到達。リアリズムがさらに向上し、限定テストおよびUltraサブスクリプション・APIチャネルでの提供準備が進められている。 |
1. Genie 1(2024年3月):ラベルなし動画から「操作されること」を学ぶ
初代Genie 1の最大の功績は、アクションのラベル(どのボタンを押したか等のデータ)が付与されていない大量のインターネット動画から、教師なし学習によって「操作可能な環境」を生成できることを証明した点にあります。110億パラメータのモデルであり、テキストや画像、手描きのスケッチから世界を作ることができましたが、当時はまだ2D環境しか生成できず、動作も秒間約1フレームと、リアルタイム性には課題がありました。
2. Genie 2(2024年):3Dインタラクティブ世界への突入
同年に登場したGenie 2では、一気にリッチな3D空間の生成へと踏み出しました。キャラクターがジャンプしたり、泳いだり、物体を動かしたりといった行動に対して環境がリアルに反応するようになり、一度視界から外れた場所を約10秒間記憶しておく視覚的記憶能力を備えました。
3. Genie 3(2025年8月):リアルタイム操作と物理法則の融合
2025年8月に発表されたGenie 3は、Genie 2の知見と動画生成モデル「Veo 3」の能力(物理法則や物体間の相互作用に対する深い理解)を吸収した汎用ワールドモデルです。解像度720p、フレームレート24fpsでの滑らかなリアルタイム操作を達成し、プロンプトによって世界の中で起きるイベントを動的に変化させる機能も追加されました。
4. Genie 4(2026年10月):視聴覚の統合とシミュレーション時間の倍増
そして今回のGenie 4では、これまでの視覚中心のシミュレーションに「音」が加わり、持続時間も大幅に伸びました。単なる映像の生成から、視覚と聴覚を伴う総合的な体験環境へとステップアップしています。
3. Genie 4を解剖する:コア能力のアップグレードと技術的ロジック
ここでは、Genie 4で公式に確認されている新しいブレークスルーと、これまでのシリーズや実験的プロトタイプ「Project Genie」を通じて明かされている基盤技術・操作体系について整理します。
1. Genie 4で確認された3つの主要な進化
- ネイティブ音声生成(Native Audio):前世代までの「無音の世界」から脱却し、リアルタイムのインタラクティブなシミュレーションにおいて、環境の動きや状況に合致したネイティブ音声を直接生成できるようになりました。これにより、仮想空間への没入感が飛躍的に高まっています。
- シミュレーション時間の倍増(最大約2分間):Quartzの報道によれば、Genie 4の1回あたりのシミュレーション時間は最大約2分間に達し、これはGenie 3の上限の2倍にあたります。(※なお、前世代であるGenie 3の持続時間や視覚的記憶の上限については、過去の資料によって「約1分間」とする記述や「数分間(multiple minutes)」とする記述が混在していましたが、Genie 4においてシミュレーション時間が大幅に延長されたことは確実です。)
- かつてないリアリズム(Unprecedented Realism):Google DeepMindが公式に強調している通り、映像のディテールや物理的な環境フィードバックの精度がさらに引き上げられ、実写(フォトリアル)に迫る表現力を獲得しています。
2. 基盤メカニズムとインタラクション体験(GenieシリーズおよびProject Genieの仕組みから)
Genie 4単体の詳細なアーキテクチャはまだ公開されていませんが、Genieシリーズおよびその体験用プロトタイプである「Project Genie」の仕組みを知ることで、このモデルがどのように動いているのかを理解することができます。
- コア・アーキテクチャの基礎:Genieシリーズは「時空間Transformer(spatiotemporal transformer)」に分類され、各フレームの内容と時間経過に伴うシーンの変化をモデル化します。初代Genie 1のアーキテクチャは、時空間ビデオトークナイザー、自己回帰ダイナミクスモデル、そしてスケーラブルな**潜在アクションモデル(latent action model)**の3要素で構成されており、実際の操作ラベルがなくてもフレームごとのインタラクションを実現する仕組みが確立されました。
- Project Genieにおけるワークフロー:
- マルチモーダルな世界構築:実験的リサーチプロトタイプであるProject Genieでは、プロンプトの理解に「Gemini」が統合されています。ユーザーはテキストプロンプトや、アップロードまたは生成した画像を使って、無限に多様でフォトリアルな世界やキャラクターを作成できます。
- World Sketching(世界のスケッチとプレビュー):「Nano Banana Pro」が統合されており、実際に世界の中に入る前に画像をプレビュー・修正したり、一人称視点か三人称視点かを設定したりすることが可能です。また、既存の世界をベースに作り変える「ワールド・リミキシング(world remixing)」にも対応しています。
- リアルタイム操作:移動手段(歩行、乗車、飛行、運転など)を定義した上で、キーボードのWASDキーで移動、矢印キーで視点変更、スペースキーで上昇といった直感的な操作が可能です。ユーザーの進行に合わせて前方のルートがリアルタイムで生成され、カメラアングルの調整やGoogleストリートビューとの統合機能も備えています。
3. 未公開の技術パラメータに関する注意点
客観的な事実として、今回のGenie 4の発表は研究アナウンスメントの段階であり、Genie 4の具体的な解像度、フレームレート、パラメータ数、アーキテクチャの変更点、および「プロンプトによる世界イベント制御」の有無については、現時点の公開資料では明かされていません。また、Genie 1の際にはarXivで技術論文が公開されましたが、Genie 3では技術レポートが「近日公開」とされたままの状態であり、Genie 4に正式な論文や技術レポートが付属しているかどうかも現時点では言及されていません。したがって、Genie 3のスペック(720p/24fpsなど)をそのままGenie 4の確定仕様として当てはめることは避ける必要があります。
4. 代表的な応用シナリオ:「AIによるゲーム生成」を超えて
Genie 4のようなワールドモデルの進化は、単なるデモンストレーションにとどまらず、複数の産業領域に具体的な変革をもたらす可能性を秘めています。
1. ゲームのプロトタイピングとインタラクティブ・エンターテインメント
Project Genieの環境はリアルな物理法則を備えており、オブジェクトはユーザーの操作に対して適切に反応します。そのため、プロンプトを使って探索可能な環境やキャラクター、さらには「ミニゲーム」を素早く構築することができます。実際に、前世代のモデルを試したジャーナリストが、『ゼルダの伝説』や『スーパーマリオ』風のシーンを模倣して作成した事例も報告されています。
Fast CompanyのThomas Smith氏は、Genieが将来的に個人の好みに合わせたカスタム世界の構築を支援し、これまでにない新しいゲームジャンルを生み出す可能性があると指摘しています。なお、Genieシリーズが発表された際、その破壊的ポテンシャルへの警戒感から、複数のビデオゲーム関連企業の株価が下落するという市場の反応も見られました。
2. ロボット工学と身体性AI(Embodied AI)の訓練
Googleが最も重視する用途の一つが、ロボットやAIエージェントのための「無限の訓練空間」としての活用です。現実世界でロボットを訓練するには莫大なコストと物理的なリスクが伴いますが、ワールドモデルを使えば安全な仮想空間で何度でも試行錯誤が可能です。
たとえば、「悪天候の中で走行する自動運転車」や「山岳地帯を滑空するウィングスーツのフライヤー」といった複雑で危険なシナリオをシミュレートしたり、予期せぬ突発的な状況に対するエージェントの対応力を鍛えたりすることができます。
3. 映画制作、コンテンツ制作、そして教育
公式発表では、映画制作、ジャーナリズム、ゲーム、製造業などが活用分野として挙げられています。クリエイターは頭の中にある想像上の世界やファンタジーの風景、表現力豊かなアニメーションキャラクターを即座に生成し、映像制作のプレビジュアライゼーション(事前視覚化)などに役立てることができます。
また、教育や研究の現場においても、教室にいながらにして古代都市の遺跡や宇宙空間といった没入型のシーンをリアルタイムに探索するような、新しい学習体験の提供が期待されています。
5. 冷静な視点:現在の限界、技術的課題、そして利用方法
Genie 4の映像やコンセプトは非常に魅力的ですが、開発者やクリエイターが実務への導入を検討する上では、現在の技術的ボトルネックを冷静に見極める必要があります。
1. 現段階における4つの主な限界
- 本質は「フレームごとの2Dレンダリング」であり、3Dアセットではない:Genie 3の仕様を参考にすると、モデルが生成しているのは「3Dのような環境の2Dレンダリング映像」であり、1フレームずつ画像を生成しているに過ぎません。既存のゲームエンジン(Unreal EngineやUnityなど)にそのままエクスポートして編集できるような3Dモデリングツールではない点に注意が必要です。
- 世界の一貫性と長期記憶の維持は依然として難題:Project Genieチーム自身が認めている通り、インタラクティブな操作が続く中で「世界の一貫性(consistency)と記憶(memory)」をいかにして保つか(視線を戻したときに風景が変わっていないか、物理的な破綻が起きないか)は、現在もコアとなる技術的課題です。シミュレーション時間が約2分に伸びたとはいえ、長時間の安定したプレイにはまだ壁があります。
- プロダクトとしてはまだ初期プロトタイプの段階:海外メディアのMashableが前世代のProject Genieについて「遊ぶことはできるが、それ自体が何か実用的な仕事をするわけではない(主に研究プロジェクトである)」と評したように、現時点では完成された産業用ツールというよりも、未来の可能性を示す実験的プロトタイプという側面が強いと言えます。
- 技術レポートの不在:前述の通り、Genie 3以降、詳細な技術レポートや論文の公開が見送られている(あるいは遅れている)状態が続いており、外部の研究者がモデルの内部挙動や限界を正確に検証するための情報が限られています。
2. 開発者やクリエイターはどうやって試せるのか?
Google DeepMindの発表によると、Genie 4へのアクセスは以下のチャネルを通じて段階的に提供されます。
- 信頼できるテスター(Trusted Testers):現在すでに、少数の信頼できるテスターに向けた段階的なロールアウトが開始されています。
- Google AI Ultraサブスクリプション加入者:一般向けの体験環境である「Project Genie」を通じて、Google AI Ultraの加入者向けに「まもなく(soon)」提供される予定です。(※参考として、Genie 3の時点では米国の18歳以上のGoogle AI Ultra加入者を対象に
labs.google/projectgenieにて公開されていました。) - エンタープライズおよび開発者チャネル:早期アクセスパートナー(early access partners)は、Gemini APIおよびGoogle AI Studioを通じてGenie 4の機能を利用できるようになります。
- 公式デモの視聴:現時点でアクセス権を持たない一般ユーザーは、Google DeepMindの公式ブログにて公開されているデモンストレーション映像を通じて、その実力を確認することができます。
おわりに
ネイティブ音声の獲得、最大約2分間へのシミュレーション時間の倍増、そしてさらなるリアリズムの向上を果たした「Genie 4」は、AIが「静的な画像や一方通行の動画を生成するツール」から、「人間やAIエージェントがリアルタイムに関与できる動的な世界を生成する基盤」へと確実に進化していることを示しています。
3Dアセットとしての出力ができない点や、長期的な空間の一貫性維持など、実用化に向けてクリアすべき課題はまだ残されています。しかし、Project Genieを通じたコンシューマー向けの展開に加え、Gemini APIやAI Studioを通じた開発者向けの提供が視野に入ったことで、ワールドモデルはいよいよ研究室のデモから開発者エコシステムへと足を踏み入れようとしています。ゲーム開発、映像制作、そしてロボティクスや身体性AIに携わるすべてのプレイヤーにとって、Genie 4が切り拓く「シミュレートされた世界」の動向は、今後も目が離せないテーマとなるはずです。